换了马甲也认得
写过爬虫的都知道,最怕的不是网站难爬,是网站改版。
昨天还跑得好好的,今天一跑,全是空的。你的选择器认的是“第三个 div 里头那个 class 叫 price 的 span”,人家前端小哥手一抖,把 class 改个名,你就得连夜返工。
跟认人一个道理:你只认他那件衣裳,人家换了件马甲,你就不认识了。
最近有个开源项目,专治这个毛病。

先说是个啥
项目叫 Scrapling,作者 Karim Shoair,埃及人,简介里管自己叫“网页抓取专家”。
2024 年 10 月开张,到现在 9 万颗星(我看的时候是 90,095),9 千多个 fork,BSD-3-Clause 协议,Python 写的,最新版本是 v0.5,文档写得挺全。
一句话:一个 Python 爬虫框架,从抓一个页面到爬一整个网站,都管。看家本事有俩:网站改版了,选择器能自己把东西找回来;自带隐身模式,对付 Cloudflare 这类反爬。
换了马甲也认得
这是它最拿手的一招,叫自适应(adaptive)。
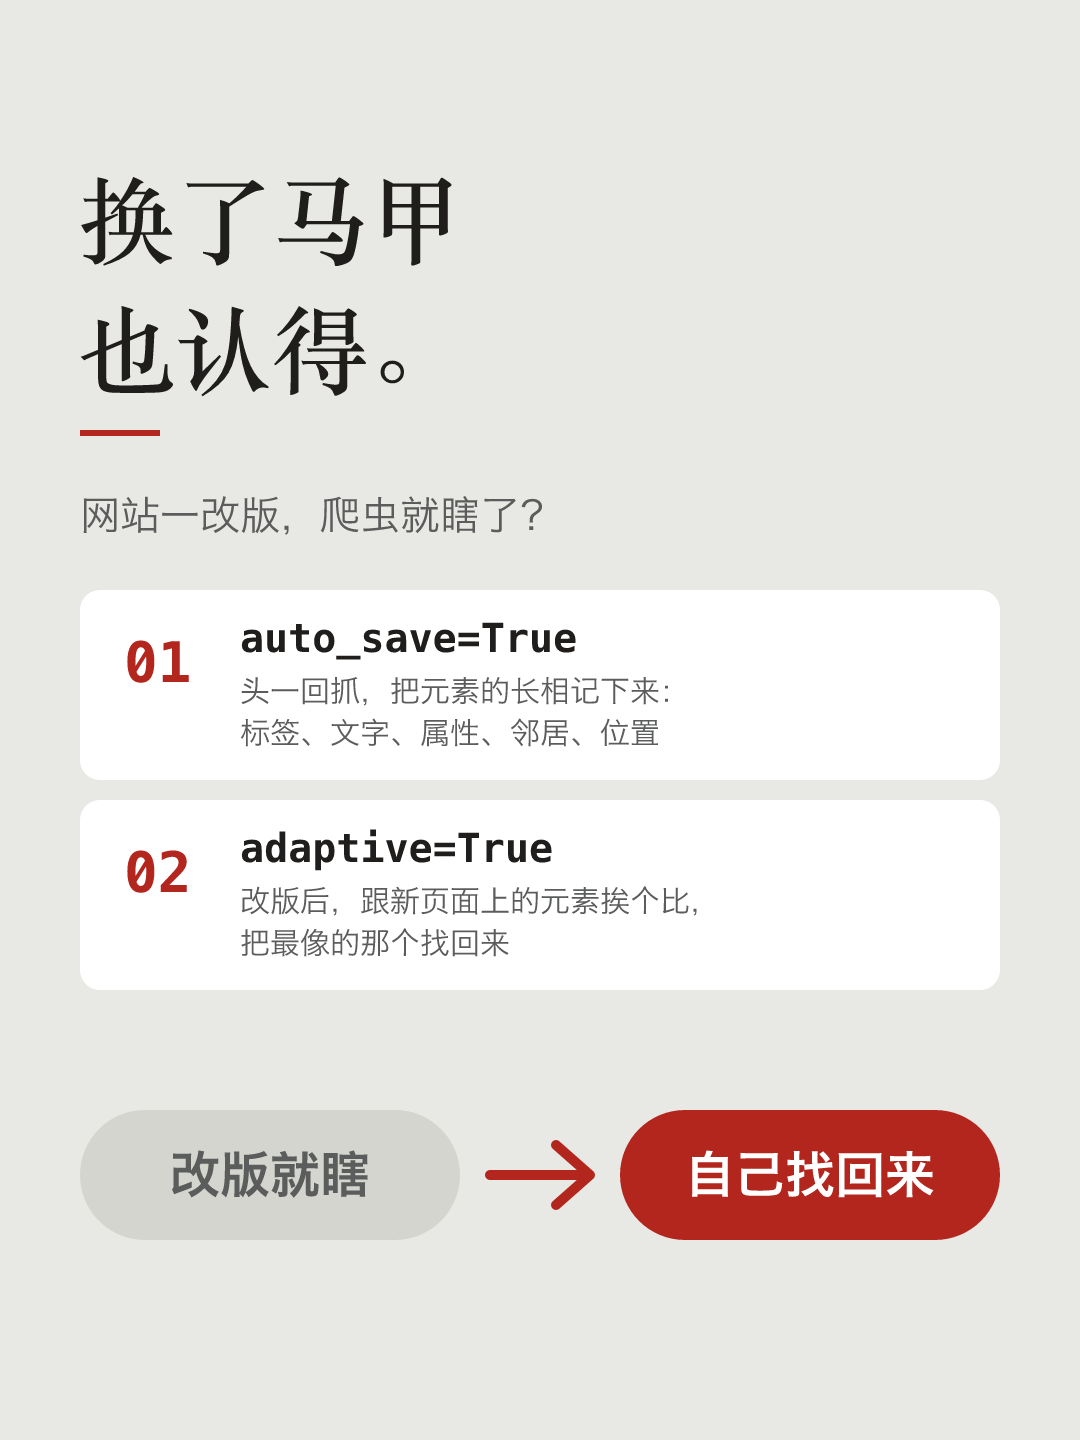
头一回抓的时候,加个 auto_save=True,它把你要的那个元素的“长相”记下来:标签名、文字、属性、左邻右舍是谁、在页面里的位置,连它爹长什么样都记着,存在本地的一个 SQLite 里。
等网站改了版,原来的选择器找不着了,换成 adaptive=True。它拿记下的长相,跟新页面上每个元素挨个比,打个相似度分,把最像的那个给你找回来。
from scrapling.fetchers import Fetcher

Fetcher.adaptive = True
page = Fetcher.get("https://quotes.toscrape.com/")

# 头一回:认准了,记下来
quotes = page.css(".quote .text", auto_save=True)

# 改版以后:原来的选择器失灵了,照着记下的长相去找
quotes = page.css(".quote .text", adaptive=True)
网站连域名都换了,再加个 adaptive_domain,告诉它新旧是一家。
当然,这本事也有边界:它比的是像不像,人家要是把整个页面拆了重盖,它也只能干瞪眼。另外,一个选择器只记第一个元素,同一个名字再存一遍会把旧的盖掉。
两个抓取器,各管一摊
- Fetcher:发普通的 HTTP 请求,跑静态页。能把 TLS 指纹和请求头装得跟真浏览器一样,还支持 HTTP/3。
- StealthyFetcher:开一个隐身的浏览器,跑那些靠 JavaScript 加载的动态页,对付反爬;Cloudflare 的 Turnstile 验证和那种“请稍候”的拦截页,它也有法子处理。
老版本里还有一个单独的 DynamicFetcher,专跑动态页,v0.5 把它删了,这活儿也归了 StealthyFetcher。网上的老教程照着抄,会报错,先看看官方的升级说明。
说句实在话:没有哪个工具能保证百分之百过 Cloudflare。人家一升级策略,今天好使的招儿明天就可能失灵。README 里说能“轻松绕过所有类型”,听听就好。
爬一整个网站
单页抓着不过瘾,它还有一套 Spider 框架,写法跟老牌的 Scrapy 差不多:给个 start_urls,写个异步的 parse。
from scrapling.spiders import Spider, Response

class QuotesSpider(Spider):
    name = "quotes"
    start_urls = ["https://quotes.toscrape.com/"]

    async def parse(self, response: Response):
        for quote in response.css(".quote"):
            yield {"text": quote.css(".text::text").get()}

result = QuotesSpider().start()
result.items.to_json("quotes.json")
该有的都有:并发,按域名限速,一个爬虫里混着用普通请求和隐身浏览器,代理轮换,被拦了自动重试。爬到一半按 Ctrl+C 停下,下回接着爬,不用从头来。结果直接导成 JSON、JSONL、CSV、XML。
还有这些零碎
- 命令行:一行代码不写也能抓,
scrapling extract get 网址 quotes.md,页面直接存成 Markdown。 - MCP Server:Claude、Cursor 这些 AI 工具能直接调它去抓网页。
- 转 Markdown:
page.markdown()一行,把页面变成干干净净、能喂给大模型的文字。 - 登录状态:登一次,存下来,下回接着用。
- 解析快:它自己测的,从五千个嵌套元素里抽文字,Scrapling 2 毫秒不到,BeautifulSoup 要一秒半。
装起来,Python 3.10 以上:
pip install "scrapling[fetchers]"
scrapling install
第二条是装浏览器。只用解析和普通请求的话,pip install scrapling 就够了;要 MCP,装 scrapling[ai]。
规矩得先说在前头
爬虫这行,本事是一回事,规矩是另一回事。
Scrapling 的 README 末尾写得明白:仅供学习和研究;用它就得遵守当地和国际上关于数据抓取、隐私的法律;尊重网站的服务条款和 robots.txt。
它自己也备着守规矩的家伙事儿:
robots_txt_obey:打开以后,照着网站的 robots.txt 办,哪儿不让进就不进,让慢点儿就慢点儿。- AutoThrottle:看网站回得快慢自己调节奏,人家一开始限流,它就退一步。
- 开发模式:头一回把页面存到本地,往后调代码都用存下的,不用一遍遍去敲人家服务器。
顺便一提,README 往下翻,赞助商一水儿全是卖代理 IP 的。这行靠什么吃饭,一目了然。
最后说两句
爬虫最怕网站改版,Scrapling 让它不怕了:人家换了马甲,它照样认得。
网站换了马甲,它认得;人家门口挂着“谢绝入内”的牌子,你也得认得。